مدلهای GPT-6 Sol و GPT-6 Luna شرکت OpenAI به GitHub Copilot آمدند
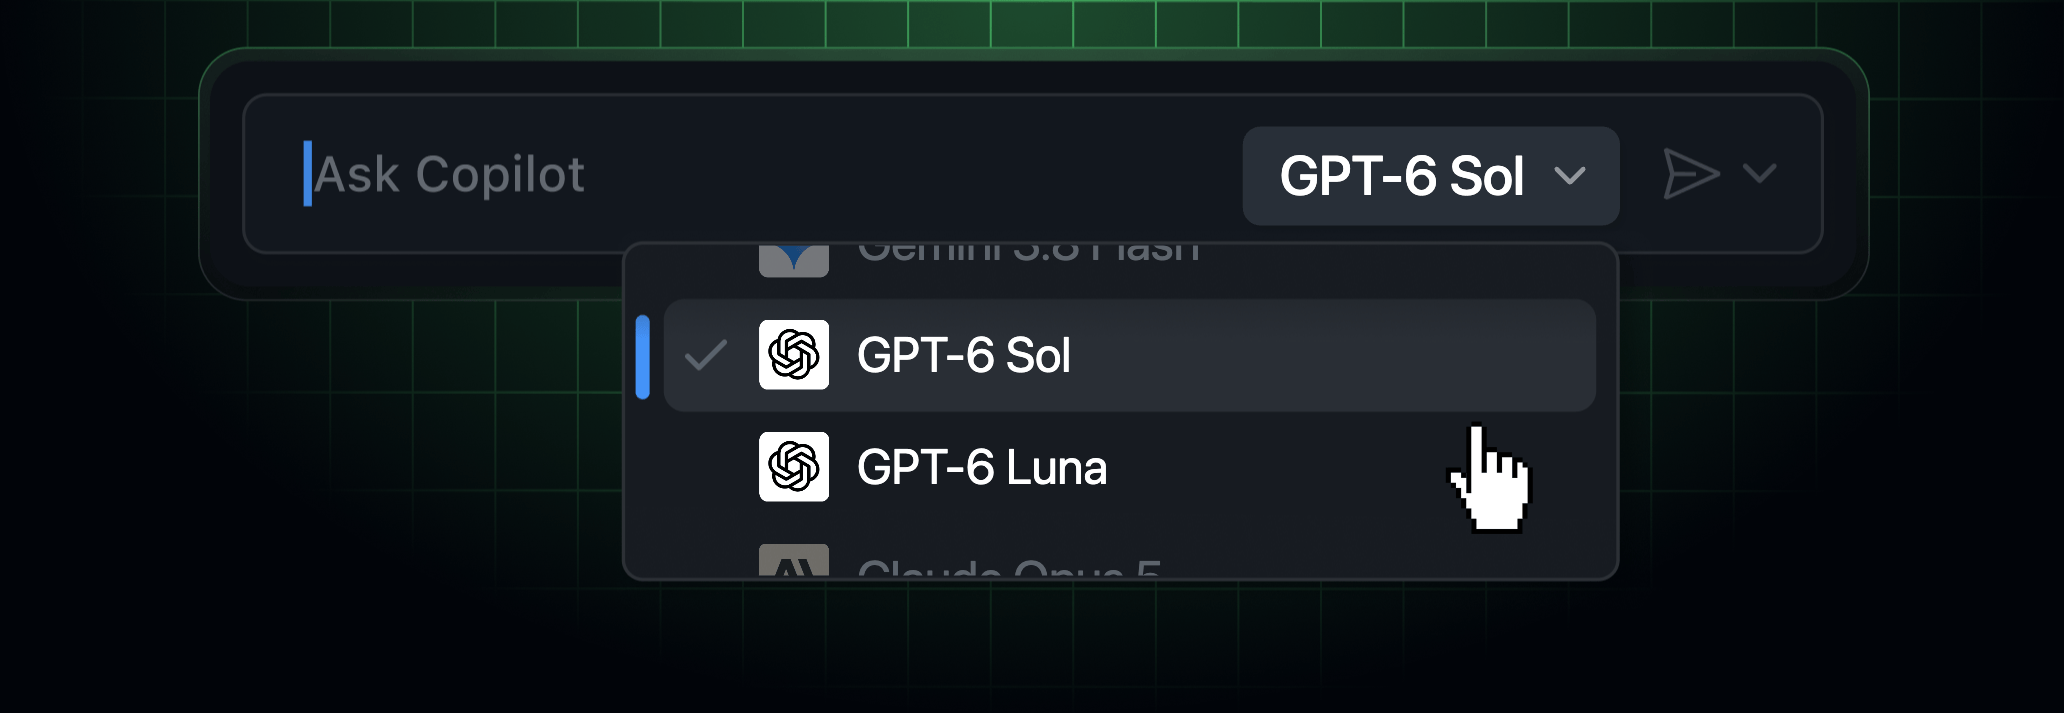
گیتهاب با اضافهکردن مدلهای GPT-6 Sol و GPT-6 Luna به GitHub Copilot، گام دیگری در مسیر توسعه نرمافزار چندمدلی برداشته است. با این تغییر، توسعهدهندگان میتوانند بسته به پیچیدگی کار، سرعت موردنیاز و هزینه قابلقبول، مدل مناسبتری را انتخاب کنند.
تفاوت GPT-6 Sol و GPT-6 Luna
GPT-6 Sol برای برنامهنویسی تعاملی و عاملمحور طراحی شده است و در وظایف چندمرحلهای، بهویژه کارهایی که به اعتبارسنجی و بررسیهای متوالی نیاز دارند، کاربرد بیشتری دارد.
GPT-6 Luna گزینهای سریعتر و کمهزینهتر برای کارهای کوچکتر، سادهتر و پرتعداد محسوب میشود. این مدل میتواند برای وظایفی مانند خلاصهسازی، تولید تست، طبقهبندی و اصلاحات محدود در کد انتخاب مناسبی باشد.
دسترسی و ابزارهای پشتیبانیشده
GPT-6 Sol برای کاربران پلنهای Pro+، Max، Business و Enterprise ارائه میشود. GPT-6 Luna علاوه بر این گروهها، برای کاربران Pro نیز در دسترس است. انتشار این مدلها تدریجی است و ممکن است دسترسی همه کاربران همزمان فعال نشود.
هر دو مدل را میتوان در ابزارها و محیطهای مختلفی انتخاب کرد، از جمله:
- VS Code و Visual Studio
- Copilot CLI
- عامل ابری GitHub Copilot
- محیطهای توسعه JetBrains
- Xcode و Eclipse
- وبسایت GitHub و اپلیکیشن موبایل
اهمیت این تغییر برای تیمهای مهندسی
برای تیمهای توسعه، نکته اصلی فقط انتخاب قدرتمندترین مدل نیست. اکنون باید برای هر نوع کار، مدل مناسب بر اساس پیچیدگی، هزینه، زمان پاسخ، کیفیت خروجی و میزان بازبینی انسانی انتخاب شود.
این رویکرد، اهمیت بنچمارک داخلی، ثبت مصرف توکن، سنجش نرخ موفقیت وظایف و پایش رفتار مدلها در فرایندهای CI/CD را افزایش میدهد. تیمها باید بدانند هر مدل در مخازن واقعی آنها چه عملکردی دارد و استفاده از آن چه میزان بازکاری یا نظارت انسانی ایجاد میکند.
تحلیل و برداشت
برداشت من از این مطلب این است که...
اهمیت فنی این خبر فقط به اضافهشدن دو مدل جدید محدود نمیشود؛ GitHub Copilot در حال تبدیلشدن به لایهای برای ارکستراسیون چندمدلی در چرخه عمر توسعه نرمافزار است. تیمها میتوانند کارهای پیچیده و عاملمحور را به Sol بسپارند، وظایف پرتعداد مانند خلاصهسازی، تولید تست، طبقهبندی و اصلاحات ساده را با Luna انجام دهند و Astra را برای سناریوهایی نگه دارند که به بالاترین سطح توانایی نیاز دارند.
این تفکیک میتواند هزینه و زمان پاسخ را کاهش دهد، اما تنها در صورتی نتیجه مطلوب خواهد داشت که با اندازهگیری دقیق همراه باشد. سازمانها باید برای مخازن واقعی خود شاخصهایی مانند موفقیت وظیفه، مصرف توکن، زمان اجرا، میزان بازکاری، نرخ خطا و مقدار بازبینی انسانی را ثبت کنند.
همچنین تفاوت رفتار مدلها، سطح دسترسی، قابلیت بازتولید خروجی و سیاستهای حاکمیتی باید در فرایندهای CI/CD و بازبینی کد مدیریت شود. انتخاب مدل بدون انجام بنچمارک داخلی ممکن است صرفهجویی ظاهری ایجاد کند، اما در ادامه هزینههای پنهانی مانند خطا، بازکاری و نظارت بیشتر را به تیم تحمیل خواهد کرد.
هنوز دیدگاهی تایید نشده است.